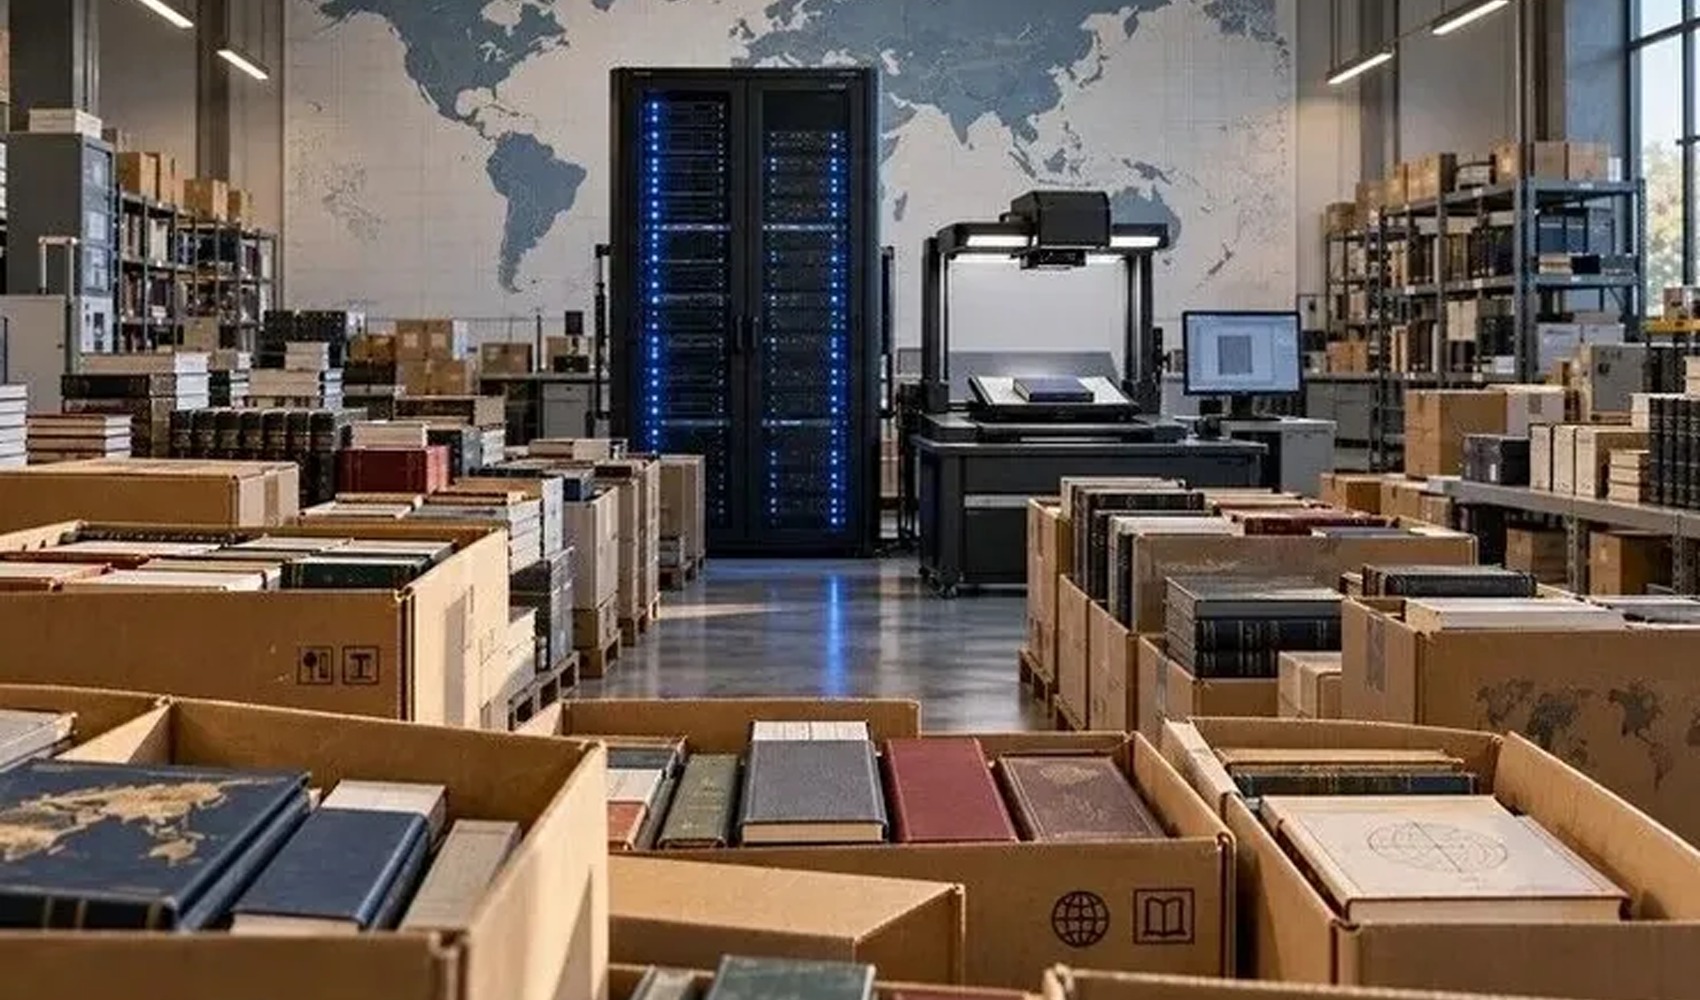
I tentativi delle aziende di intelligenza artificiale di trasformare libri cartacei e digitali in set di dati su larga scala hanno riportato al centro del dibattito nel settore editoriale la questione del copyright e dell'utilizzo dei dati.
Il Prof. Dr. Selçuk Beşir Demir ha annunciato di aver respinto la richiesta di un'azienda globale di accedere a 17 mila libri accademici. Demir ha sottolineato che tali richieste non possono essere considerate semplici attività tecniche di raccolta dati, poiché potrebbero avere gravi conseguenze per editori, autori e produzione accademica.
Definendo il processo come una "guerra tra la Silicon Valley e l'industria della cellulosa", Demir ha affermato che i meccanismi di copyright e di autorizzazione devono essere protetti nei contenuti utilizzati per l'addestramento dei modelli di intelligenza artificiale.
La preoccupazione principale nel mondo dell'editoria è che la scansione massiva dei libri e il loro utilizzo nell'addestramento dei sistemi di intelligenza artificiale indeboliscano i diritti di reddito, controllo e citazione degli autori. Si afferma che questa situazione potrebbe aumentare il rischio di "sfruttamento dei dati" e di contrazione del mercato, in particolare per le pubblicazioni accademiche in lingua turca.
Demir ha lanciato un appello per la creazione di un quadro di protezione più solido contro le violazioni del copyright, sottolineando che la produzione di contenuti locali deve essere garantita nel processo di trasformazione digitale dell'editoria accademica.
Fonte della notizia: 12punto